多云韧性:关键在于编排,而不是云的数量

Résilience multicloud : tout est une question d’orchestration, pas du nombre de clouds

Silicon.fr Quality unknown · 质量未知 by Amit Kapoor* 2026-09-25 09:52 Original
摘要
文章指出,多云并不能自动保证业务连续性:若各云之间互联与故障切换设计不足,仍可能出现单点故障。Gartner预计2026年主权云基础设施支出将增长35.6%,法国如SAMU信息系统与IGN的Géoportail等关键公共服务已部署在本土云上,推动“云-网络-安全”一体化;企业因此需要端到端的集中编排与自动化(含实时链路监测、自动重路由)以及统一网络层(SD-WAN/SASE/Zero Trust等需一致管理)来提升韧性与降低成本。文中提到Tata Communications欧洲区副总裁兼负责人Amit Kapoor,强调韧性取决于将多平台连接、可观测并作为“单一环境”编排,而非平台数量本身。

长期以来,多云被视为应对云厂商依赖和单点故障的自然答案:把应用和数据分散到多个平台,似乎就能获得更高的灵活性与韧性。但现实是,每个云都有各自的工具、安全策略和连接方式,再叠加数据中心、在线软件和遗留系统,复杂度迅速上升。单个环境即便运行良好,也未必能作为整体协同工作。真正的挑战已不再是“把应用放在哪个云上”,而是如何确保访问顺畅、数据流动无阻,并对整个基础设施保持一致视图。

这种趋势也体现在市场投入上。Gartner预计,2026年主权云基础设施支出将增长35.6%,反映出企业和公共部门希望更好地掌控数据、治理和技术依赖。在法国,SAMU信息系统和IGN的Géoportail等关键服务已经部署在法国云上,说明云基础设施已成为公共服务的重要底座。也因此,云、网络和安全不能再分开看;从用户体验角度,它们实际上是一条连续链路。

不过,多云本身并不能自动带来业务连续性。即便一个应用同时部署在两个云上,如果这些云——无论是否主权云——没有正确互联,仍然可能存在单点故障。要真正实现容灾,必须有一个可用的备用环境,在连接中断时立即接管;连续性设计、维护和定期测试都不可或缺。这意味着要同步数据、配置访问权限、验证故障切换机制,并从应用、数据、用户、云和网络之间的关系出发,端到端设计韧性。

因此,企业越来越需要一个集中式编排层,提供统一可视化、策略管理,以及跨云和网络环境的自动化与控制能力。系统应能快速发现性能退化、迅速定位原因,并尽量减少人工干预地重新路由流量。实时监控链路并自动重定向,可以把切换时间从“人工处理的分钟级”压缩到“几秒钟”。如果没有这种端到端的集中编排,多云只能提供冗余能力,却无法保证高效的服务连续性。

在这种架构下,网络成为统一各环境的关键层。它连接用户、站点、数据中心和云,同时提供流量可视性。当应用变慢时,企业必须判断问题究竟出在平台、连接、安全策略还是应用本身。统一网络层还能在不同环境中实施一致的分段、加密和访问控制,避免工作负载从一个云迁移到另一个云时安全级别下降。

网络还必须适配不同场景:协作工具、工业应用和AI平台的数据量与时延要求并不相同。智能网络可以优化流量和云连接,优先保障关键服务,并在性能下降时自动切换到其他路径。这不仅提升应用性能,也能减少不必要的数据传输和数据出站成本。SD-WAN、SASE和Zero Trust都能发挥作用,但前提是统一管理;如果各自孤立部署,反而会增加复杂性。

AI进一步放大了这种互依关系。一个AI项目往往依赖分布在多个位置的数据,以及来自多个供应商的算力资源。模型性能固然重要,但如果数据无法高效流动,处理延迟和成本会随着项目规模扩大而上升。多云和混合云管理需要专业能力,也会带来更高的运营成本、更长的问题解决时间和更大的组织风险。

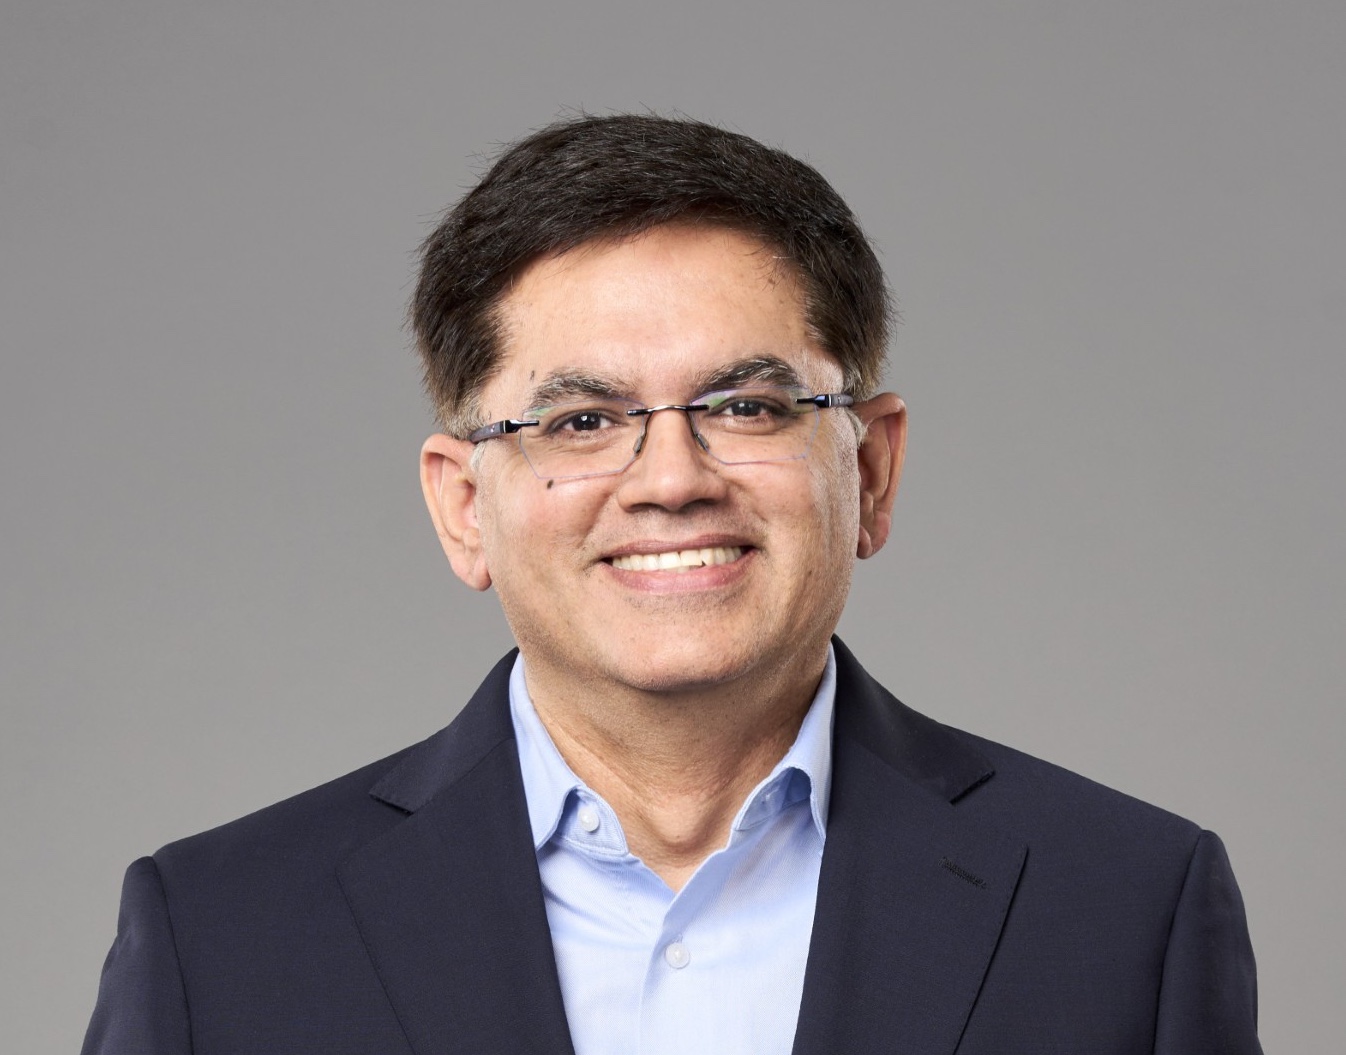
因此,企业下一步不是盲目增加云平台数量,而是通过统一管理让现有云环境更好协同。通过编排、自动化和持续优化,组织可以提升敏捷性,更有效利用网络资源,并降低运营成本。真正的韧性不取决于平台有多少,而取决于能否把它们连接、观察并编排成一个统一环境。Amit Kapoor是Tata Communications欧洲区副总裁兼部门负责人。

Summary
The article argues that “multicloud by default” doesn’t ensure continuity: even with multiple cloud providers, outages can still occur if connectivity, data synchronization, failover, and security policies aren’t designed and continuously tested end-to-end. It cites Gartner’s forecast that spending on sovereign cloud infrastructure will rise 35.6% in 2026, noting France’s critical public services (e.g., SAMU’s information system and IGN’s Géoportail) running on French clouds, and emphasizes that network, security, and cloud must be treated as a single chain. It highlights the need for centralized orchestration and unified networking (e.g., SD-WAN/SASE/Zero Trust managed coherently) to enable real-time monitoring, automated traffic rerouting, and better performance—an approach positioned as especially important as AI increases cross-environment dependencies.

Pendant longtemps, le multicloud a été présenté comme la réponse naturelle aux risques de dépendance vis-à-vis d’un seul fournisseur et aux pannes. Répartir applications et données sur plusieurs plateformes devait apporter plus de flexibilité et de résilience. Mais cette logique atteint vite ses limites : chaque cloud dispose de ses propres outils, politiques de sécurité et mécanismes de connectivité, auxquels s’ajoutent les centres de données, les logiciels en ligne et les systèmes hérités. Résultat, des environnements peuvent être performants isolément sans fonctionner efficacement comme un ensemble cohérent.

Le véritable enjeu n’est donc plus seulement de choisir où héberger une application, mais de garantir un accès fluide, des flux de données continus et une vision unifiée de l’infrastructure. Gartner prévoit d’ailleurs que les dépenses liées aux infrastructures de cloud souverain progresseront de 35,6 % en 2026, signe d’une volonté accrue de mieux contrôler les données, la gouvernance et les dépendances technologiques. En France, des services critiques comme le système d’information du SAMU et le Géoportail de l’IGN reposent déjà sur des clouds français, illustrant le rôle devenu central du cloud dans les services publics essentiels.

Dans ce contexte, cloud, réseau et sécurité ne peuvent plus être pensés séparément : du point de vue de l’expérience utilisateur, ils forment une chaîne unique. Or, le multicloud seul ne garantit pas la continuité de service. Une application peut être déployée sur deux clouds et rester vulnérable à un point de défaillance unique si ces environnements, souverains ou non, ne sont pas correctement interconnectés. Il faut donc un environnement secondaire prêt à reprendre la connectivité en cas d’incident, avec synchronisation des données, configuration des accès et tests réguliers des mécanismes de basculement. La résilience doit être conçue de bout en bout, en intégrant les liens entre applications, données, utilisateurs, clouds et réseaux.

Les entreprises recherchent ainsi une couche d’orchestration centralisée capable d’offrir une visibilité unifiée, une gestion des politiques et des fonctions d’automatisation sur l’ensemble des environnements cloud et réseau. L’objectif est de détecter rapidement les dégradations de performance, d’en identifier la cause et de réacheminer le trafic avec un minimum d’intervention manuelle. La surveillance en temps réel des liaisons, associée à un réacheminement automatique, permet un basculement en quelques secondes plutôt qu’après une action humaine. Sans cette orchestration de bout en bout, le multicloud n’apporte qu’une redondance partielle, pas une continuité de service réellement efficace.

Le réseau devient alors la couche unificatrice. Dans une architecture distribuée, il relie utilisateurs, sites, datacenters et clouds tout en donnant de la visibilité sur les flux. Lorsqu’une application ralentit, il faut pouvoir déterminer si la cause vient de la plateforme, de la connexion, d’une politique de sécurité ou de l’application elle-même. Une couche réseau unifiée permet d’appliquer des règles cohérentes de segmentation, de chiffrement et de contrôle d’accès sur tous les environnements, afin qu’une charge de travail migrée d’un cloud à un autre ne perde pas en niveau de sécurité pendant le transfert.

Le réseau doit aussi s’adapter aux usages. Les outils collaboratifs, les applications industrielles et les plateformes d’IA n’ont ni les mêmes volumes de données ni les mêmes exigences de latence. Une mise en réseau intelligente peut optimiser les flux, prioriser les services critiques et basculer automatiquement les charges de travail vers un autre chemin si les performances se dégradent. Cela améliore les performances applicatives tout en réduisant les transferts inutiles et les coûts de sortie de données. Des approches comme SD-WAN, SASE et Zero Trust peuvent répondre à ces besoins, à condition d’être pilotées de manière cohérente ; déployées en silos, elles ajoutent au contraire de la complexité.

L’IA renforce encore ces interdépendances. Un projet d’IA s’appuie souvent sur des données réparties sur plusieurs emplacements et sur des ressources de calcul fournies par plusieurs prestataires. La performance du modèle ne suffit pas : si les données circulent mal, les délais de traitement et les coûts augmentent à mesure que le projet prend de l’ampleur. La gestion de clouds multiples et d’environnements hybrides exige donc une expertise spécialisée, avec à la clé des coûts opérationnels plus élevés, des temps de résolution plus longs et davantage de risques.

La prochaine étape pour les entreprises consiste à faire mieux fonctionner ensemble leurs environnements existants grâce à une gestion unifiée. En combinant orchestration, automatisation et optimisation continue, elles peuvent gagner en agilité, mieux utiliser les ressources réseau et réduire leurs coûts. La résilience ne dépend pas du nombre de plateformes, mais de la capacité à les connecter, les observer et les orchestrer comme un environnement unique.

Résumé
Le texte souligne que le multicloud ne garantit pas, à lui seul, la continuité de service : sans interconnexion, orchestration et tests de basculement, une application peut rester exposée à un point de défaillance unique. Gartner prévoit une hausse de 35,6 % des dépenses en infrastructures de cloud souverain en 2026, tandis qu’en France des services critiques (SAMU, Géoportail de l’IGN) reposent sur des clouds français, renforçant l’idée que cloud, réseau et sécurité doivent être traités comme une chaîne unique. La solution mise en avant est une couche d’orchestration centralisée et unifiée (avec des approches type SD-WAN/SASE/Zero Trust gérées de façon cohérente) pour observer les performances en temps réel, réacheminer automatiquement le trafic et mieux gérer les interdépendances, notamment celles liées aux projets d’IA.

Pendant longtemps, le recours à plusieurs fournisseurs cloud a semblé être la réponse évidente aux risques liés à la dépendance et aux pannes. La répartition des applications et des données sur plusieurs plateformes devait offrir davantage de flexibilité et de résilience.

Le cloud entre dans une nouvelle phase de contrôle

Pourtant, chaque cloud possède ses propres outils, politiques de sécurité et méthodes de connectivité. Cette complexité est accentuée par les centres de données, les logiciels en ligne et les systèmes hérités. Chaque environnement peut afficher de bonnes performances de manière autonome sans pour autant fonctionner efficacement au sein d’un ensemble cohérent.

Le défi ne consiste donc plus simplement à décider où héberger une application, mais à garantir un accès aisé, des flux de données fluides et une vision cohérente de l’ensemble de l’infrastructure.

Selon Gartner, les dépenses consacrées aux infrastructures de cloud souverain devraient augmenter de 35,6 % en 2026. Cette hausse reflète une volonté de mieux maîtriser les données, la gouvernance et les dépendances technologiques.

En France, des services critiques tels que le système d’information du SAMU et le Géoportail de l’IGN sont hébergés sur des clouds français. Les infrastructures cloud soutiennent désormais des services publics essentiels. Le cloud, le réseau et la sécurité ne peuvent plus être envisagés séparément : du point de vue de l’expérience utilisateur, ils forment une chaîne unique.

Le multicloud seul ne garantit pas la continuité de service

Travailler avec plusieurs fournisseurs réduit certains risques de dépendance, mais cela ne suffit pas à garantir la continuité de service. Une application peut être déployée sur deux clouds tout en restant exposée à un point de défaillance unique si ces clouds, souverains ou non, ne sont pas correctement interconnectés.

Un environnement secondaire doit donc être disponible et prêt à prendre le relais de la connectivité en cas de panne. La continuité doit être conçue, maintenue et régulièrement testée. Cela implique de synchroniser les données, de configurer les accès et de tester les mécanismes de basculement. La résilience doit être envisagée de bout en bout, en tenant compte des relations entre les applications, les données, les utilisateurs, les clouds et les réseaux.

Les entreprises recherchent de plus en plus une couche d’orchestration centralisée offrant une visibilité unifiée, une gestion des politiques, ainsi que des capacités d’automatisation et de contrôle à travers les environnements cloud et réseau. Elles doivent pouvoir détecter les dégradations de performance, en identifier rapidement la cause et réacheminer le trafic avec un minimum d’intervention manuelle.

La surveillance des liaisons en temps réel avec un réacheminement automatique, permet ainsi un basculement en quelques secondes plutôt qu’après une intervention manuelle. Sans ce niveau d’orchestration centralisée de bout en bout, le multicloud fournit une capacité redondante, mais ne garantit pas une continuité de service efficace.

Le réseau devient la couche unificatrice

Dans une architecture distribuée, le réseau relie les utilisateurs, les sites, les centres de données et les clouds, tout en offrant une visibilité sur les flux de trafic. Lorsqu’une application ralentit, les organisations doivent déterminer si le problème vient de la plateforme, de la connexion, d’une politique de sécurité ou de l’application elle-même.

Une couche réseau unifiée permet à une entreprise d’appliquer des mesures cohérentes de segmentation, de chiffrement et de contrôle d’accès à travers différents environnements. Ainsi, une charge de travail migrant d’un cloud à un autre ne se retrouve pas avec un niveau de sécurité amoindri au cours du transfert.

Le réseau doit également s’adapter aux différents cas d’usage. Les outils collaboratifs, les applications industrielles et les plateformes d’IA ne génèrent pas les mêmes volumes de données et n’ont pas les mêmes exigences en matière de latence. Une mise en réseau intelligente peut optimiser les flux de trafic et la connectivité cloud, en privilégiant les services critiques et en basculant automatiquement les charges de travail vers un autre chemin lorsque les performances se dégradent.

Cela améliore les performances de l’applications tout en réduisant les transferts de données inutiles et les coûts de sortie des données. Les approches SD-WAN, SASE et Zero Trust peuvent contribuer à répondre à ces besoins, à condition d’être gérées de manière cohérente. Déployées en silos, elles ajoutent une couche de complexité supplémentaire.

Passer du multicloud par défaut au multicloud conçu comme tel

L’IA accroît encore davantage les interdépendances. Un projet d’IA s’appuie souvent sur des données stockées dans plusieurs emplacements et sur des ressources informatiques fournies par plusieurs prestataires. Les performances du modèle ne suffisent pas à elles seules : si les données ne peuvent pas circuler efficacement, les délais de traitement et les coûts augmentent à mesure que le projet prend de l’ampleur.

La gestion de clouds multiples et d’environnements hybrides nécessite une expertise spécialisée, ce qui entraîne pour les organisations une hausse des coûts opérationnels, une durée de résolution des problèmes plus longues et des risques accrus pour les organisations.

L’étape suivante pour les entreprises consiste donc à faire mieux fonctionner ensemble leurs environnements cloud existants grâce à une gestion unifiée. En combinant orchestration, automatisation et optimisation continue, les organisations gagnent en agilité, utilisent plus efficacement les ressources réseau et réduisent leurs coûts opérationnels.

La résilience ne dépend pas du nombre de plateformes. Elle repose sur la capacité à les connecter, à les observer et à les orchestrer comme un environnement unique.

*Amit Kapoor est Vice-président et directeur de la division Europe chez Tata Communications

The post Résilience multicloud : tout est une question d’orchestration, pas du nombre de clouds appeared first on Silicon.fr.
AI Insight
Core Point

Multicloud resilience depends on end-to-end orchestration, unified visibility, and automated failover—not on simply using more cloud providers—because connectivity, security, and data flows can still create single points of failure.

Key Players

Tata Communications (Amit Kapoor) — enterprise networking/communications provider, based in India; advocates orchestration and unified network control across cloud environments.

Industry Impact
  • ICT: High — emphasizes unified orchestration, real-time link monitoring, and automated traffic re-routing across cloud/network/security.
  • Computing/AI: Medium — AI projects amplify cross-site data movement and inter-provider dependencies, making orchestration and data mobility critical.
  • Energy: Low — only indirect relevance via infrastructure efficiency/cost optimization, no direct energy focus.
  • Terminals/Consumer Electronics: Low — no consumer device angle.
  • Automotive: Low — no automotive-specific content.
Tracking

Monitor — rising sovereign cloud spend and the shift from “multicloud by default” to “multicloud designed” increases demand for orchestration, SD-WAN/SASE/Zero Trust integration, and automated failover tooling.

Related Companies
Gartner
mature
neutral
neutral
neutral
Categories
软件 云计算 电信
AI Processing
2026-09-25 11:37
openai / gpt-5.4-nano